

假設你看到兩張心電圖,其中一條曲線突然下降。這會讓你想問:「為什麼?」但單靠一條線,還不能知道是什麼疾病、哪條訊號通路出了問題。基因變異的分子預測也一樣。
昨天 Day 23,我們把一批人工 VCF 候選整理成固定欄位與審閱封包。今天挑其中一筆人工變異 chr1:110:A>G,為它準備 REF(參考)與 ALT(替代)兩條純人工代理軌跡,練習逐點相減、畫圖、保留證據來源,再把差分轉成下一步研究問題。
本篇仍採用最初的「Google AI Studio 快速做出 MVP → VS Code 用 Python 逆向拆解」學習方法。先看到自己想做的儀表板,再學會每一個顯示欄位背後的程式處理。
若 REF 與 ALT 有相同的座標、相同資料模態、相同單位與相同細胞情境,我們才能對齊每個位置計算:
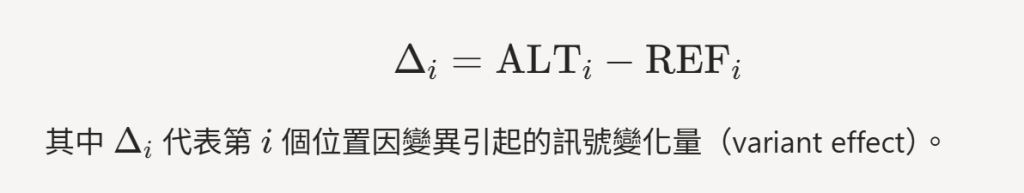
在這份人工教學資料中,五個位置的計算如下:
| 1-based 位置 | REF proxy | ALT proxy | ALT − REF | 如何讀? |
|---|---|---|---|---|
| 108 | 0.20 | 0.20 | 0.00 | 人工值相同 |
| 109 | 0.30 | 0.55 | +0.25 | ALT 代理訊號較高 |
| 110 | 0.40 | 0.10 | −0.30 | 最大絕對差分,但負號必須保留 |
| 111 | 0.25 | 0.35 | +0.10 | ALT 代理訊號較高 |
| 112 | 0.20 | 0.20 | 0.00 | 人工值相同 |
max(abs(Delta))=0.30,但對應位置的帶符號數值是 −0.30,位置為 110。
這裡的 0~1 數值,是我們自己設定的任意代理單位,不是剪接機率、ATAC 訊號、AVI 分數或實驗結果。 某個位置下降,不等於已證實剪接受損、增強子遭破壞、基因表現降低,也不等於罹病風險升高。
Day 23 審閱封包中,人工變異 chr1:110:A>G 通過了教學 QC,附有 synthetic_score=-0.17、review_status=REVIEW_REQUIRED。今天的 −0.30 是另一套獨立設計的人工軌跡數值。兩者雖然使用相同的虛構變異 ID,但沒有經過官方模型校準,不能相加、相乘、擅自平均或做致病排名。
以前初學 Python,常常一打開 VS Code 就看到空白編輯器,不知道從哪個函式開始。這一篇改用逆向拆解:
AI_STUDIO_DAY24_PROMPT.txt,先建立只有人工資料的 REF/ALT 儀表板。| AI Studio 上看得見的畫面 | Python 背後的函式 | 這一步學到什麼 |
|---|---|---|
| 人工資料輸入 | load_json()、check_track_fixture() |
不合規資料不能進分析 |
| REF/ALT 曲線與 Delta | compare_tracks() |
逐點相減、保留方向 |
| Day 23 審閱資訊 | check_day23_packet() |
連接前一天的人工候選、不混淆分數 |
| 16:9 科普軌跡圖 | render_svg() |
從數字生成真正可檢查的圖 |
| 瀏覽器面板 | render_html() |
讓表格、圖形與證據標籤對齊 |
| 匯出報告 | emit_artifacts() |
JSON/CSV/SVG/HTML 的各自用途 |
本篇的圖是 Python 以合成數據繪製的 960×540 向量圖,背景使用 #E5DEDA,與先前專欄的視覺規格一致。圖上明列來源,不將它裝成真實模型圖。
這次提供兩個可獨立核對的輸入:
| 檔案 | 內容 | 證據層級 |
|---|---|---|
day24_synthetic_tracks.json |
五個人工位置與 REF/ALT 軌跡 | SYNTHETIC_EDUCATIONAL_DEMO |
day23_annotation_report.json |
Day 23 已產生的合成標註報告副本 | SYNTHETIC_EDUCATIONAL_DEMO;非官方 AVI |
Python 先檢查:是否為 TOY_NOT_GRCH38、變異是否是合法的教學 SNV 格式、五個位置是否連續、REF/ALT 兩條數列是否等長、各數值是否在 0~1、是否有 NaN/Infinity,以及 Day 23 的同一人工變異是否為 SELECTED 並保留 REVIEW_REQUIRED。
如果輸入錯誤,程式會停止,而不是輸出看似漂亮、實際錯位的圖。程式也記錄輸入檔 SHA-256,供之後確認使用了哪個位元內容版本。雜湊不會自動證明資料真實或具有臨床效度。
positions_1based=[108,109,110,111,112] 是本例人工的 1-based 位置清單,並沒有使用 GRCh38 FASTA 驗證 chr1:110:A>G 的 REF。Day 20 的 0-based BED/1-based VCF 課程仍然適用;但本篇不會將缺乏參考驗證的人工數列當成真實基因座軌跡。
請先下載完整教學 ZIP,解壓後同一資料夾至少應有:
Day24/
├── day24_offline_refalt_track_lab.py
├── test_day24_offline_refalt_track_lab.py
├── day24_synthetic_tracks.json
├── day23_annotation_report.json
├── AI_STUDIO_DAY24_PROMPT.txt
└── README_Day24_REF_ALT_Track_API_Bridge_Lab.md
只需要 Python 3.12 標準函式庫。不需要 GPU、SDK、API Key 或私人 GitHub。下面是主程式的完整程式碼;想先理解核心,可直接跳到 compare_tracks(),它負責計算 Delta,其他函式主要處理輸入檢查及輸出。
"""Day 24 | OFFLINE REF/ALT proxy-track delta explorer.

Standalone Python 3.12+ standard-library lesson.  All coordinates, alleles,
tracks and scores are SYNTHETIC.  The optional Day23 link is a prior synthetic
annotation packet, not a biological prediction or a clinical classification.
No AlphaGenome import, API key access, network calls, or patient data.
"""
from __future__ import annotations

import argparse
import csv
import hashlib
from html import escape
import json
import math
from pathlib import Path
import re
import xml.etree.ElementTree as ET

EVIDENCE_CLASS = "SYNTHETIC_EDUCATIONAL_DEMO"
MODE = "OFFLINE_ONLY"
ASSEMBLY = "TOY_NOT_GRCH38"
TRACK_SCHEMA = "day24.synthetic.refalt_tracks.v1"
RESULT_SCHEMA = "day24.synthetic.refalt_delta.v1"
PACKET_SCHEMA = "day23.synthetic.annotation.v1"
VARIANT_RE = re.compile(r"(chr(?:[1-9]|1[0-9]|2[0-2]|X|Y|M)):([1-9][0-9]*):([ACGT])>([ACGT])\Z")
SVG_NS = "http://www.w3.org/2000/svg"
ET.register_namespace("", SVG_NS)


def load_json(path: str | Path, *, max_bytes: int = 1_000_000):
    """Read a small UTF-8 JSON file. These are local teaching fixtures only."""
    source = Path(path)
    if not source.is_file() or source.stat().st_size > max_bytes:
        raise ValueError("Required local JSON fixture missing or too large")
    try:
        record = json.loads(source.read_text(encoding="utf-8"))
    except (UnicodeError, json.JSONDecodeError) as exc:
        raise ValueError("Invalid UTF-8 JSON fixture") from exc
    return record


def source_record(path: str | Path):
    """Content hash records byte identity, not provenance authenticity."""
    source = Path(path)
    return {"filename": source.name, "sha256": hashlib.sha256(source.read_bytes()).hexdigest()}


def split_variant(variant_id):
    if not isinstance(variant_id, str) or not (match := VARIANT_RE.fullmatch(variant_id)):
        raise ValueError("Expected artificial SNV chrN:position:REF>ALT")
    chrom, position, ref, alt = match.groups()
    if ref == alt:
        raise ValueError("REF and ALT must differ")
    return chrom, int(position), ref, alt


def check_track_fixture(track):
    """Strict synthetic-only track contract, including geometry and numeric checks."""
    if not isinstance(track, dict):
        raise ValueError("Track fixture must be an object")
    required = {
        "schema_version": TRACK_SCHEMA,
        "evidence_class": EVIDENCE_CLASS,
        "mode": MODE,
        "assembly": ASSEMBLY,
        "track_label": "ARTIFICIAL_SIGNAL_PROXY",
        "track_unit": "UNIT_INTERVAL_0_TO_1_TOY",
        "biosample": "TOY_CELL_CONTEXT_NOT_REAL_TISSUE",
        "coordinate_system": "1-based positions",
        "model_prediction": False,
        "official_atlas_data": False,
        "real_api_calls_this_run": 0,
    }
    for field, expected in required.items():
        # bool is a subclass of int: compare types as well as values.
        if field not in track or type(track[field]) is not type(expected) or track[field] != expected:
            raise ValueError(f"Unexpected / non-synthetic track field: {field}")
    _, variant_pos, _, _ = split_variant(track.get("variant_id"))
    positions, ref, alt = (track.get(name) for name in ("positions_1based", "ref", "alt"))
    if not all(isinstance(x, list) for x in (positions, ref, alt)):
        raise ValueError("Track arrays must be lists")
    if not (2 <= len(positions) <= 1000 and len(ref) == len(alt) == len(positions)):
        raise ValueError("REF/ALT tracks require the same 2-1000 positions")
    if any(type(p) is not int or p < 1 for p in positions):
        raise ValueError("Positions must be positive 1-based integers")
    if any(right != left + 1 for left, right in zip(positions, positions[1:])):
        raise ValueError("Track positions must increase consecutively")
    if not (positions[0] <= variant_pos <= positions[-1]):
        raise ValueError("Variant must fall within the displayed track")
    for value in [*ref, *alt]:
        if (type(value) not in (float, int) or not math.isfinite(value)
                or not (0 <= value <= 1)):
            raise ValueError("Artificial proxy values must be finite numbers from 0 to 1")
    return track


def check_day23_packet(packet, variant_id):
    """Require the same selected SYNTHETIC candidate, not an unknown LIVE score."""
    if not isinstance(packet, dict):
        raise ValueError("Day23 packet must be an object")
    contract = {
        "schema_version": PACKET_SCHEMA,
        "evidence_class": EVIDENCE_CLASS,
        "mode": MODE,
        "assembly": ASSEMBLY,
        "official_avi": False,
        "atlas_query_performed": False,
        "clinical_interpretation": False,
        "real_api_calls_this_run": 0,
    }
    for field, expected in contract.items():
        if field not in packet or type(packet[field]) is not type(expected) or packet[field] != expected:
            raise ValueError(f"Day23 input not verified as synthetic: {field}")
    annotations = packet.get("annotations")
    if not isinstance(annotations, list) or not annotations:
        raise ValueError("Day23 annotations missing")
    selected_count = packet.get("selected_count")
    if type(selected_count) is not int or selected_count != len(annotations):
        raise ValueError("Day23 selected-count contract mismatch")
    seen = set()
    matched = None
    for annotation in annotations:
        if not isinstance(annotation, dict):
            raise ValueError("Malformed Day23 annotation")
        vid = annotation.get("variant_id")
        split_variant(vid)
        if vid in seen:
            raise ValueError("Duplicate Day23 annotation")
        seen.add(vid)
        if (annotation.get("qc_status") != "SELECTED"
                or annotation.get("review_status") != "REVIEW_REQUIRED"
                or annotation.get("score_source") != "SYNTHETIC_FIXTURE_ONLY"):
            raise ValueError("Day23 annotation review/source mismatch")
        score = annotation.get("synthetic_score")
        expected_state = "MISSING_SCORE" if score is None else "SYNTHETIC_SCORE"
        if score is not None and (type(score) not in (float, int) or not math.isfinite(score)):
            raise ValueError("Invalid Day23 teaching score")
        if annotation.get("score_status") != expected_state:
            raise ValueError("Day23 score missing-value mismatch")
        if vid == variant_id:
            matched = annotation
    if matched is None:
        raise ValueError("Track variant has no selected entry in Day23")
    return {"variant_id": variant_id,
            "qc_status": "SELECTED",
            "score_status": matched["score_status"],
            "synthetic_score": matched["synthetic_score"],
            "review_status": "REVIEW_REQUIRED",
            "note": "Day23 annotation and Day24 track are independently invented; DO NOT combine their scores"}


def compare_tracks(track, *, day23_packet=None, track_provenance=None, packet_provenance=None):
    """Compare one synthetic REF/ALT track, retaining provenance and uncertainty."""
    check_track_fixture(track)
    variant_id = track["variant_id"]
    linked = check_day23_packet(day23_packet, variant_id) if day23_packet is not None else None
    positions, ref_values, alt_values = (track[k] for k in ("positions_1based", "ref", "alt"))
    delta = [round(alt - ref, 3) for ref, alt in zip(ref_values, alt_values)]
    peak = max(range(len(delta)), key=lambda i: abs(delta[i]))
    rows = [{"position_1based": pos, "ref_proxy": ref, "alt_proxy": alt,
             "delta_alt_minus_ref": diff, "variant_here": pos == split_variant(variant_id)[1]}
            for pos, ref, alt, diff in zip(positions, ref_values, alt_values, delta)]
    return {
        "schema_version": RESULT_SCHEMA,
        "evidence_class": EVIDENCE_CLASS,
        "mode": MODE,
        "assembly": ASSEMBLY,
        "variant_id": variant_id,
        "track_label": track["track_label"],
        "track_unit": track["track_unit"],
        "biosample": track["biosample"],
        "coordinate_system": track["coordinate_system"],
        "point_count": len(rows),
        "point_rows": rows,
        "delta_definition": "ALT_proxy - REF_proxy",
        "largest_absolute_delta_position_1based": positions[peak],
        "largest_absolute_delta": delta[peak],
        "day23_annotation_link": linked,
        "mechanism_questions": [
            "若是真實資料,訊號的測量模態與單位是什麼?",
            "是否有對應細胞、基因組版本、轉錄本與獨立實驗證據?",
            "相同位置的差分是否能重複,還是只是示範數列?",
        ],
        "mechanism_status": "HYPOTHESIS_ONLY_NOT_VALIDATED",
        "model_prediction": False,
        "official_atlas_data": False,
        "reference_allele_verified": False,
        "clinical_interpretation": False,
        "atlas_query_performed": False,
        "real_api_calls_this_run": 0,
        "input_provenance": {"track_fixture": track_provenance,
                             "day23_packet": packet_provenance},
    }


def render_svg(report):
    """960x540 single-file SVG; two traces + signed delta in separate panels."""
    root = ET.Element(f"{{{SVG_NS}}}svg", {
        "width": "960", "height": "540", "viewBox": "0 0 960 540",
        "role": "img", "aria-label": "Synthetic REF ALT proxy tracks and signed delta, not model predictions",
    })
    def elem(parent, name, attrs=None, label=None):
        child = ET.SubElement(parent, f"{{{SVG_NS}}}{name}", attrs or {})
        if label is not None:
            child.text = str(label)
        return child
    elem(root, "rect", {"width": "960", "height": "540", "fill": "#E5DEDA"})
    elem(root, "text", {"x": "55", "y": "48", "font-size": "29", "font-weight": "700", "fill": "#38404a"}, "Day 24 | Synthetic REF / ALT Delta")
    elem(root, "text", {"x": "55", "y": "76", "font-size": "16", "fill": "#8c3450"}, "SYNTHETIC EDUCATIONAL DATA · NOT AlphaGenome output")
    elem(root, "rect", {"x": "50", "y": "96", "width": "860", "height": "250", "rx": "15", "fill": "#fffdfc"})
    elem(root, "rect", {"x": "50", "y": "360", "width": "860", "height": "128", "rx": "15", "fill": "#fffdfc"})
    rows = report["point_rows"]
    n = len(rows)
    chart_left, chart_width, ymin, ymax = 112, 750, 130, 304
    x = lambda i: chart_left + (i * chart_width / (n-1))
    y = lambda val: ymax - val * (ymax - ymin)
    for tick in (0, 0.25, 0.5, 0.75, 1):
        yy = y(tick)
        elem(root, "line", {"x1": "109", "y1": f"{yy:.2f}", "x2": "868", "y2": f"{yy:.2f}", "stroke": "#dfe5e7", "stroke-width": "1"})
        elem(root, "text", {"x": "61", "y": f"{yy+5:.2f}", "font-size": "13", "fill": "#66747e"}, f"{tick:g}")
    for name, attr, color in (("REF", "ref_proxy", "#376c8d"), ("ALT", "alt_proxy", "#c06c78")):
        points = " ".join(f"{x(i):.2f},{y(row[attr]):.2f}" for i,row in enumerate(rows))
        elem(root, "polyline", {"points": points, "fill": "none", "stroke": color, "stroke-width": "3.8", "data-track": name})
        for i,row in enumerate(rows):
            elem(root, "circle", {"cx": f"{x(i):.2f}", "cy": f"{y(row[attr]):.2f}", "r": "5", "fill": color})
    for i,row in enumerate(rows):
        elem(root, "text", {"x": f"{x(i):.2f}", "y": "332", "text-anchor": "middle", "font-size": "13", "fill": "#465562"}, str(row["position_1based"]))
    elem(root, "circle", {"cx": "724", "cy": "116", "r": "6", "fill": "#376c8d"})
    elem(root, "text", {"x": "736", "y": "120", "font-size": "13", "fill": "#376c8d"}, "REF")
    elem(root, "circle", {"cx": "795", "cy": "116", "r": "6", "fill": "#c06c78"})
    elem(root, "text", {"x": "807", "y": "120", "font-size": "13", "fill": "#c06c78"}, "ALT")
    elem(root, "text", {"x": "65", "y": "380", "font-size": "15", "fill": "#374454", "font-weight": "bold"}, "Signed delta = ALT - REF")
    zero_y = 425
    elem(root, "line", {"x1": "109", "y1": str(zero_y), "x2": "868", "y2": str(zero_y), "stroke": "#9fa9b1", "stroke-width": "1.6"})
    deltas = [row["delta_alt_minus_ref"] for row in rows]
    abs_max = max(max(abs(v) for v in deltas), 0.1)
    for i,row in enumerate(rows):
        delta = row["delta_alt_minus_ref"]
        y_end = zero_y - delta / abs_max * 35
        elem(root, "line", {"x1": f"{x(i):.2f}", "y1": str(zero_y), "x2": f"{x(i):.2f}", "y2": f"{y_end:.2f}", "stroke": "#9c667b", "stroke-width": "8", "stroke-linecap": "round", "data-delta-pos": str(row["position_1based"])})
        elem(root, "text", {"x": f"{x(i):.2f}", "y": "476", "text-anchor": "middle", "font-size": "13", "fill": "#465562"}, f"{delta:+g}")
    elem(root, "text", {"x": "55", "y": "515", "font-size": "13", "fill": "#465562"},
         f"{report['variant_id']} · {report['assembly']} · 1-based positions · HYPOTHESIS ONLY · real API calls: 0")
    return ET.tostring(root, encoding="unicode", xml_declaration=False)


def render_html(report, svg):
    """Self-contained browser panel; data-derived labels are HTML-escaped."""
    h = lambda value: escape(str(value), quote=True)
    table_rows = "\n".join(
        "<tr>" + "".join(f"<td>{h(row[field])}</td>" for field in (
            "position_1based", "ref_proxy", "alt_proxy", "delta_alt_minus_ref", "variant_here")) + "</tr>"
        for row in report["point_rows"])
    linked = report["day23_annotation_link"]
    linked_text = (f"Day23 SELECTED; synthetic_score={h(linked['synthetic_score'])}; "
                   f"score_status={h(linked['score_status'])}") if linked else "No Day23 packet provided"
    questions = "".join(f"<li>{h(q)}</li>" for q in report["mechanism_questions"])
    return f'''<!doctype html><html lang="zh-Hant"><head><meta charset="utf-8"><meta name="viewport" content="width=device-width,initial-scale=1">
<title>Day 24 | Synthetic REF/ALT delta</title><style>
:root{{font:16px/1.6 system-ui,"Noto Sans TC",sans-serif;color:#343e48;background:#e5deda}}
body{{max-width:1010px;margin:0 auto;padding:26px 16px 48px}}h1{{font-size:1.8rem}}.card{{background:#fffdfc;border-radius:14px;padding:20px;margin:14px 0}}
.warning{{border-left:6px solid #c06c78}}svg{{width:100%;height:auto;display:block}}table{{border-collapse:collapse;width:100%}}
th,td{{text-align:left;border-bottom:1px solid #e7e2e2;padding:8px}}th{{background:#f3edef}}small{{color:#637280}}</style></head><body>
<h1>Day 24|REF/ALT 軌跡差分分析</h1><div class="card warning"><strong>OFFLINE_ONLY · SYNTHETIC · TOY_NOT_GRCH38</strong>
<p>下圖與所有數值都是人工教學資料,並非真實 AlphaGenome/Atlas/病人結果。訊號改變不等於剪接或增強子機制已被證實。</p></div>
<div class="card">{svg}</div>
<div class="card"><h2>人工資料與逐點差分</h2><p>最大絕對差分:<strong>{h(report['largest_absolute_delta'])}</strong>,位置:<strong>{h(report['largest_absolute_delta_position_1based'])}</strong>(1-based)。</p>
<table><thead><tr><th>位置</th><th>REF proxy</th><th>ALT proxy</th><th>ALT − REF</th><th>變異位置</th></tr></thead><tbody>{table_rows}</tbody></table></div>
<div class="card"><h2>與 Day 23 的連結</h2><p>{linked_text}</p><p><strong>注意:</strong>Day 23 的人工分數與本篇人工軌跡是獨立創作的值,不能相加、相乘或解讀成臨床風險。</p></div>
<div class="card"><h2>提出研究問題,而不是宣告疾病機制</h2><ol>{questions}</ol>
<small>Provenance SHA-256、模型限制與結構化結果見同目錄 JSON;原始輸出已保留 NULL 和人工來源標記。</small></div></body></html>'''


def emit_artifacts(track_path, day23_path, output_dir):
    """Validation precedes filesystem writes; no network or SDK calls."""
    track = load_json(track_path)
    packet = load_json(day23_path) if day23_path is not None else None
    report = compare_tracks(track, day23_packet=packet,
                            track_provenance=source_record(track_path),
                            packet_provenance=source_record(day23_path) if day23_path is not None else None)
    svg = render_svg(report)
    html = render_html(report, svg)
    output = Path(output_dir)
    output.mkdir(parents=True, exist_ok=True)
    json_file = output / "day24_track_delta_report.json"
    csv_file = output / "day24_track_delta_table.csv"
    svg_file = output / "day24_ref_alt_delta.svg"
    html_file = output / "day24_track_delta_dashboard.html"
    json_file.write_text(json.dumps(report, ensure_ascii=False, indent=2) + "\n", encoding="utf-8")
    with csv_file.open("w", newline="", encoding="utf-8") as stream:
        writer = csv.DictWriter(stream, fieldnames=("position_1based", "ref_proxy", "alt_proxy",
                                                     "delta_alt_minus_ref", "variant_here"))
        writer.writeheader()
        writer.writerows(report["point_rows"])
    svg_file.write_text(svg + "\n", encoding="utf-8")
    html_file.write_text(html, encoding="utf-8")
    return {
        "status": "PASS", "mode": MODE,
        "variant_id": report["variant_id"], "point_count": report["point_count"],
        "largest_absolute_delta_position_1based": report["largest_absolute_delta_position_1based"],
        "largest_absolute_delta": report["largest_absolute_delta"],
        "day23_linked": report["day23_annotation_link"] is not None,
        "json_file": str(json_file), "csv_file": str(csv_file),
        "svg_file": str(svg_file), "html_file": str(html_file),
        "real_api_calls_this_run": 0,
    }


def main(argv=None):
    parser = argparse.ArgumentParser(description="Day24 OFFLINE-only synthetic REF/ALT delta")
    parser.add_argument("--mode", choices=["offline"], required=True)
    parser.add_argument("--track-fixture", default="day24_synthetic_tracks.json")
    parser.add_argument("--day23-report", default="day23_annotation_report.json",
                        help="Path to the bundled Day23 synthetic report; use 'none' to skip linking")
    parser.add_argument("--output-dir", default="day24_output")
    args = parser.parse_args(argv)
    day23 = None if args.day23_report.lower() == "none" else args.day23_report
    summary = emit_artifacts(args.track_fixture, day23, args.output_dir)
    print(json.dumps(summary, ensure_ascii=False, sort_keys=True))
    return summary


if __name__ == "__main__":
    main()
你先前的 Ubuntu 沒有 unzip 指令,所以不必安裝任何套件,直接使用 Python 內建 zipfile:
cd /mnt/c/Users/user/Downloads
mkdir -p ~/alphagenome-day24-qa
python3.12 -m zipfile -e \
  AlphaGenome_Day24_REF_ALT_Track_API_Bridge_Author_Review_Pack.zip \
  ~/alphagenome-day24-qa
cd ~/alphagenome-day24-qa

# 先執行全部離線測試
python3.12 -m unittest -v test_day24_offline_refalt_track_lab

# 再執行主程式
python3.12 day24_offline_refalt_track_lab.py \
  --mode offline \
  --track-fixture day24_synthetic_tracks.json \
  --day23-report day23_annotation_report.json \
  --output-dir day24_output
--day23-report none 可在不提供 Day 23 副本時單獨練習軌跡差分。--mode live 會被參數解析器拒絕;這份腳本完全沒有真實 API 分支。
本次在 Python 3.13.5 執行主程式的 stdout(單行 JSON):
{"csv_file": "day24_output/day24_track_delta_table.csv", "day23_linked": true, "html_file": "day24_output/day24_track_delta_dashboard.html", "json_file": "day24_output/day24_track_delta_report.json", "largest_absolute_delta": -0.3, "largest_absolute_delta_position_1based": 110, "mode": "OFFLINE_ONLY", "point_count": 5, "real_api_calls_this_run": 0, "status": "PASS", "svg_file": "day24_output/day24_ref_alt_delta.svg", "variant_id": "chr1:110:A>G"}
執行後會在 day24_output/ 生成四個檔案:
| 檔案 | 功能 |
|---|---|
day24_track_delta_report.json |
完整五筆數值、人工來源、SHA-256、Day 23 連結與限制欄位 |
day24_track_delta_table.csv |
可用 Excel/試算表檢視的五列 Delta 表 |
day24_ref_alt_delta.svg |
Python 生成的 16:9 REF/ALT+Delta 科學教育圖 |
day24_track_delta_dashboard.html |
可直接在瀏覽器開啟、包含 SVG 的完整離線面板 |
請注意:測試通過代表人工軌跡演算法與檔案格式通過測試,絕不是剪接、染色質或疾病機制獲得科學驗證。
假設未來有真實模型輸出顯示某座標的 ALT 預測值比 REF 小,研究者可以依序問:
可把今天的結論寫成:「這個人工 REF/ALT 軌跡在位置 110 出現最大絕對差分 −0.30,因此值得練習提出下一步的機制檢驗問題。」
不能寫成:「這個變異已造成基因剪接異常、特定器官受損或致病率上升。」
官方 AlphaGenome Atlas 提供預先計算的變異影響分數/AVI 與特徵重要性;如果需要對某個 REF/ALT DNA 變異查詢不同模態的模型預測軌跡,則屬於 AlphaGenome Model API 的 predict_variant() 使用情境。不同模態的輸出單位與分數聚合方法不相同,不能用本篇五點的任意數列模擬官方的完整輸出契約。
本篇沒有實際呼叫 atlas.query_variant()、atlas.query_interval() 或 dna_client.predict_variant()。未來真正執行 LIVE 查詢須另行核對 SDK 版本、API Key、服務條款、來源紀錄與人工審閱;不能直接將歷史 Reboot APOL4/skin-of-body 預測移植成這個 chr1 教學圖的資料。
synthetic_score=-0.17 與本篇 Delta 不是同一種分數,不能混算。SYNTHETIC 警示。本篇五點軌跡及 Toy cell context 完全是新建的 SYNTHETIC EDUCATIONAL DEMO;Day 23 JSON 是同一系列的人工註釋成果。程式沒有測序數據、真實 REF FASTA 驗證、實際組織樣本、模型預測、實驗或臨床分類。所有數值只能證明本地 Python 的形狀檢查、Delta 算術、資料聯接與視覺化正確。
AlphaGenome Model API 的 REF/ALT 模態比較,需以相同序列/樣本條件和官方定義的資料單位解讀;它與 Atlas AVI 的統計量不是直接等價。此處將理論模型用途作為背景,不聲稱本次已使用任何真實 API。
明天 Day 25,我們會把人工 REF/ALT 數列轉成清楚的圖表,學習如何用 Python 視覺化差異,並且讓每一張圖都能追溯它來自哪份資料。


 iThome鐵人賽
 看影片追技術